はじめに
DBに1行を追加すると、その行はファイルのどこに置かれるのか。インデックスで値を見つけたあと、どうやって元の行を取り出すのか。行を書けたところでプロセスが止まったら、次に開いたときに何が残るのか。普段はDBの外から見ているこの一連の処理を、自分で書いて確かめるために go-rdbms-playground を作りました。
Goのプログラムに組み込んで使う学習用のRDBです。テーブルにスキーマと主キーを定義し、SQLを使わずGo APIで行を挿入・取得します。検索は全件取得と、1カラムに対する同値検索に絞りました。この記事では users に Alice、Bob、Carol を保存し、age = 20 で Alice と Bob を取り出すところまで追います。
まず動かしてみる
Go 1.27以上を使います。リポジトリのルートで、実験用の保存先を作ってからExplorerを起動します。
db_dir=$(mktemp -d)
go run ./cmd/migrate -data "$db_dir"
go run ./cmd/explorer -data "$db_dir" -demo=false最初のコマンドで一時ディレクトリを作り、migrate で users と age インデックスを定義します。適用履歴は同じディレクトリの migrations.json に記録され、再実行すると適用済みの定義をスキップします。Explorerの -demo=false は、組み込みのサンプル行を入れずに始めるための指定です。 マイグレーション定義 · Explorerの起動処理
ブラウザで http://127.0.0.1:8080 を開き、users の「行データ」タブで次の3行を上から順に入力します。「行を保存」を押すと、保存済みデータの一覧に追加されます。
| id | name | age | active |
|---|---|---|---|
| 1 | Alice | 20 | true |
| 2 | Bob | 20 | true |
| 3 | Carol | 30 | false |
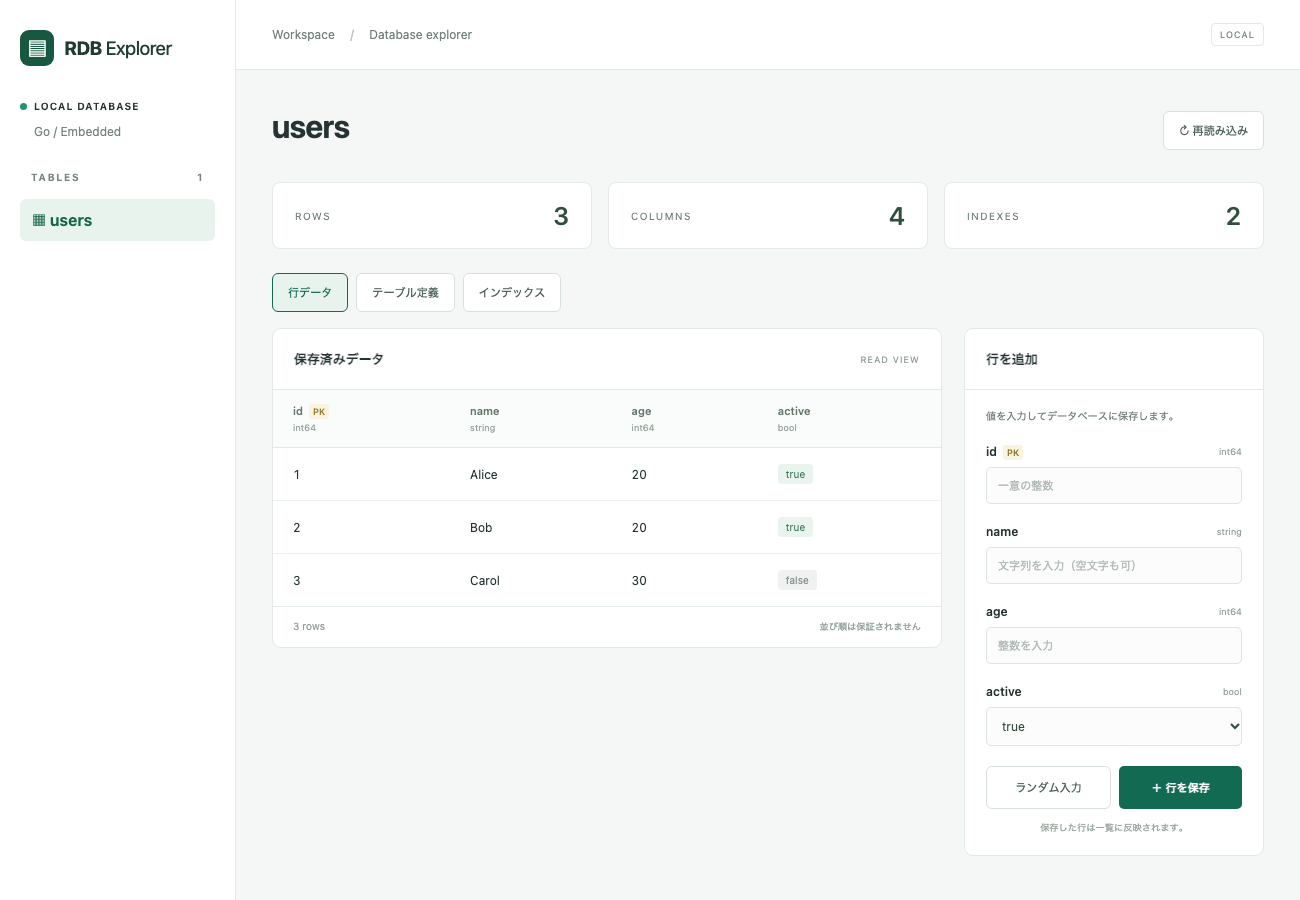
3行を追加して開き直したあとの「行データ」タブ。
Explorerを Ctrl+C で止めて、同じシェルで go run ./cmd/explorer -data "$db_dir" -demo=false をもう一度実行すると、先ほどの3行が表示されます。ブラウザの一覧は全件表示です。age = 20 の絞り込みはGo APIで行います。Explorerを停止してから、別のGoプログラムで同じ保存先を開きます。
以下は db が開いており、users が作成済みの状態で、空のテーブルに Alice を挿入して検索する抜粋です。上の手順で3行を入れたDBを使う場合は、Insert を省いて検索だけを実行します。
type User struct {
    ID     int64  `rdb:"id"`
    Name   string `rdb:"name"`
    Age    int64  `rdb:"age"`
    Active bool   `rdb:"active"`
}

users, err := db.Table[User]("users")
if err != nil {
    return err
}
if err := users.Insert(ctx, User{ID: 1, Name: "Alice", Age: 20, Active: true}); err != nil {
    return err
}

age, err := users.Column[int64]("age")
if err != nil {
    return err
}
rows, err := users.Where(rdb.Equal(age, 20)).All(ctx)
if err != nil {
    return err
}
fmt.Println(len(rows)) // Aliceだけを挿入した場合は1件。
go run ./examples/basic でも、テーブル作成から age = 20 の検索、閉じたDBを開き直すところまで試せます。このサンプルは active を省いた3カラム版で、独自の一時ディレクトリを使います。 Go APIの実行例
テーブルと行をどう表現するか
スキーマにはテーブル名、カラムごとの名前と型、主キーを記録します。Explorerの users では、id と age が整数、name が文字列、active が真偽値です。主キーの id は1カラムで、値は挿入側が指定します。同じ id がすでにあれば挿入時にエラーになります。age には同じ値を持つ行を複数入れられます。列の型は int64、string、bool に対応し、NULLは扱いません。 スキーマ定義と行の検証
db.Table[User]("users") は保存済みのテーブルとGo構造体を対応付けます。rdb:"age" のタグで User.Age を age に結び付け、挿入時には構造体をカラム名から値へのマップに変換します。検索時は逆にマップから User を組み立て、[]User を返します。
- コンパイル時に、
Table[User]に異なるモデル型を渡した挿入や、Field[User, int64]に対するrdb.Equal(age, "20")を検出できます。異なるモデル型の条件をWhereに渡した場合も型エラーです。 - 実行時に、
Table[User]の取得時点で、指定したテーブルが存在し、構造体がスキーマの全カラムに型も含めて過不足なく対応しているかを検証します。Column[string]("age")はstring自体が対応型なのでコンパイルは通り、Columnの呼び出し時に型不一致で失敗します。同じモデル型でも別テーブルや別DBのフィールドを使えば、Whereが保持したエラーをAllが返します。
ジェネリクスが型をつなぐのは、テーブルを取得したあとの挿入値、検索条件、戻り値です。文字列で指定したテーブル名やカラム名が実際に存在するかは、開いたDBの定義と照合します。 型付きAPIの実装 · コンパイル可否のテスト
行データをファイルに保存する
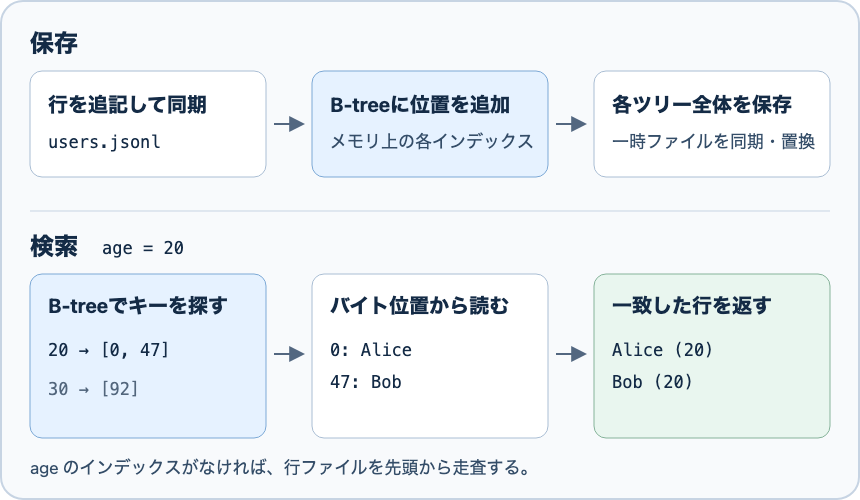
Insert は行の型と主キーの重複を確認し、行を users.jsonl の末尾に追記します。形式はJSON Linesで、1行が1つのJSONオブジェクトです。テーブル定義は catalog.json、インデックスは users.id.index.json や users.age.index.json に分かれていて、すべてDBディレクトリの直下に置かれます。3行を追加した users.jsonl は次のようになります。
{"active":true,"age":20,"id":1,"name":"Alice"}
{"active":true,"age":20,"id":2,"name":"Bob"}
{"active":false,"age":30,"id":3,"name":"Carol"}
行を書く直前にファイルの末尾まで移動すると、そこが新しい行の先頭位置です。この位置をファイル先頭からのバイト数で表したものが、バイトオフセットです。上の例では Alice が 0、Bob が 47、Carol が 92 です。改行も1バイトとして数えます。各行の長さは名前などで変わるので、2行目を読みたいときに行番号だけから開始位置を計算することはできません。そこで書き込んだ位置をインデックスに渡します。読み出すときは、その位置から次の改行までを読んで1行を復元します。 行の追記とオフセット指定の読み込み
B-treeで目的の行を探す
age インデックスがない状態で age = 20 を実行すると、users.jsonl を先頭から読み、各行をデコードして age を比較します。この例では3行目の Carol も読み、条件に一致した Alice と Bob だけを結果に入れます。主キーの id にはテーブル作成時にインデックスが付きますが、この検索条件が指定しているのは age です。
age インデックスがあれば、検索はメモリ上のB-treeのルートから始まります。ノード内の整列済みキーを二分探索し、見つからなければ、その値が入り得る範囲の子ノードに降ります。20 が見つかると、そのエントリから [0, 47] を取得します。あとは各オフセットから行を読めばよいので、92 から始まる Carol の行を検索処理でデコードする必要がありません。インデックスの作成前後で同値検索の結果が一致することは、テストでも確認しています。 検索経路の分岐 · 全走査とインデックス検索を比較するテスト
同じ年齢の行を追加したら、既存キーのオフセット一覧に1件を足します。Alice と Bob は 20 という1つのキーを共有します。この例では異なる年齢が 20 と 30 の2つなので、ルートが葉を兼ねます。
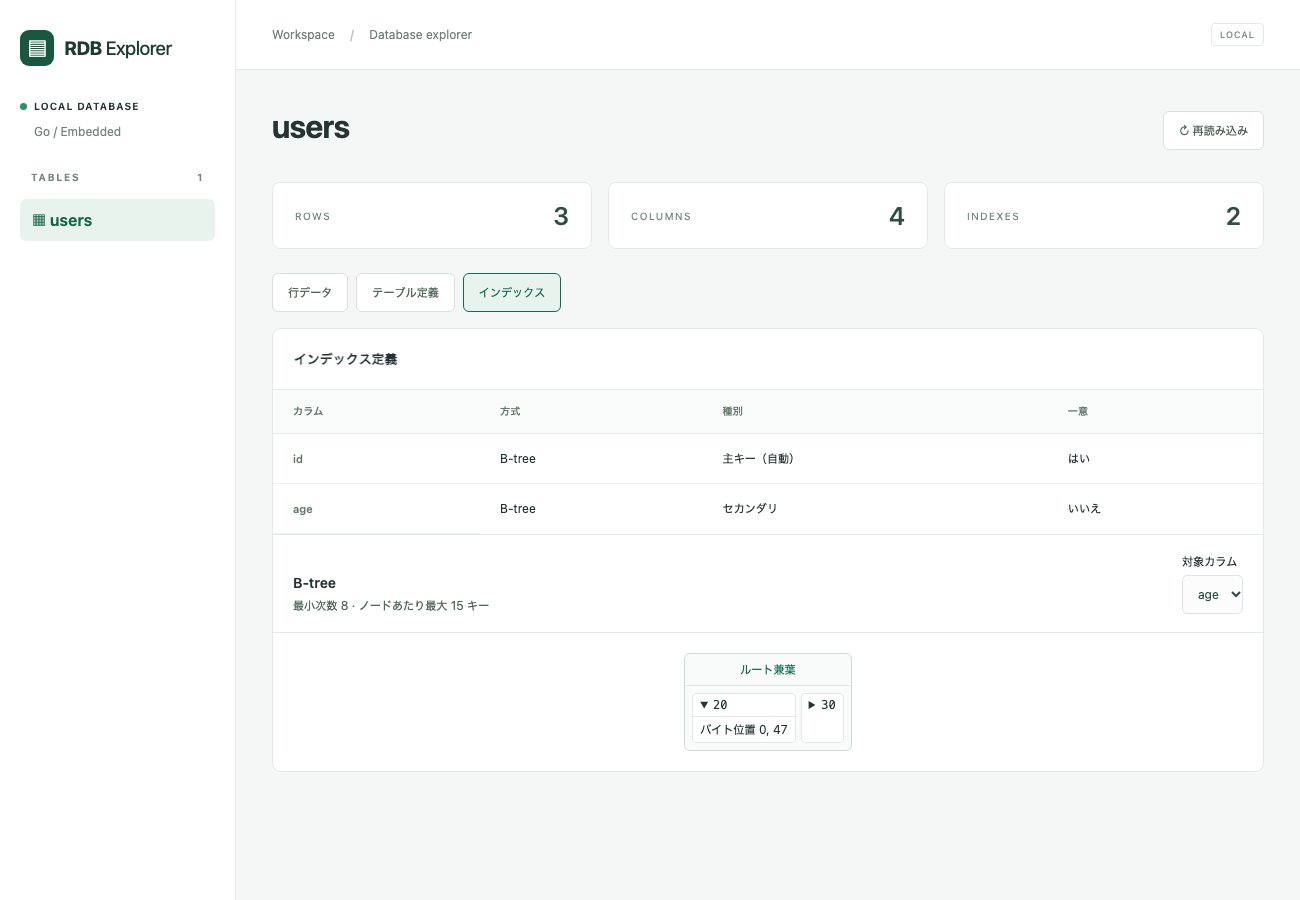
「インデックス」タブで対象カラムを age に切り替え、キー 20 を展開したところ。
このB-treeでは1ノードに最大15キーを置けます。新しいキーを入れるために満杯の子へ降りるときは、先に中央のエントリを親へ移し、残りを左右の子に分割します。ルートが満杯なら新しい親を作ります。中央のエントリを移すときには、オフセット一覧も一緒に移ります。つまり、内部ノードでキーが一致した時点で行の位置が得られます。データへの参照を葉に集めるB+treeと区別できる箇所です。 B-treeの検索・挿入・分割
保存の途中で止まったらどうするか
Alice を挿入するとき、まず改行付きの行を追記して行ファイルを Sync します。そのあとメモリ上の id と age のB-treeを更新し、それぞれのツリー全体をJSONとして同じディレクトリ内の一時ファイルに書きます。一時ファイルを Sync して閉じ、Rename で従来のインデックスファイルを置き換え、最後に親ディレクトリも Sync します。すべてのインデックスの保存が終わると、Insert は成功を返します。 挿入処理 · ファイルの同期と置き換え
ここで、行ファイルの同期後、age インデックスの保存前にプロセスが止まったとします。ディスク上にはAliceの行があり、age のインデックスにはまだ反映されていないことがあります。そこで Open は行ファイルを正として全行を読み、定義済みのインデックスをメモリ上で組み立てます。保存済みインデックスの構造を検証し、キーとオフセットをすべて照合します。両方が合えば保存済みのツリーを採用し、欠損・破損・不一致があれば、行から作ったツリーでファイルを書き直します。件数が同じでも、オフセットの誤りはこの比較で検出できます。 行からのインデックス作成 · 保存済みインデックスの照合
行の追記そのものが途中で止まり、末尾に改行のない断片が残った場合は、Open 時にその断片の開始位置でファイルを切り詰めて同期します。改行で終わる行は1行として検証し、JSONの不正や主キーの重複があれば Open が失敗します。
もう一つ確認したかったのは、Insert がエラーを返した場合です。行の同期後にインデックス保存で失敗すれば、エラーを返した行も、開き直したあとの検索に現れます。書き込み失敗で ErrNeedsRecovery が返ったら Close して Open し直し、再試行する前に主キーで存在を確認します。この実装に挿入のロールバックはありません。テストでは、行の同期直後やインデックスの置き換え途中に子プロセスを終了させ、残る行を検証しています。 失敗時の復旧テスト · プロセスを途中終了させるテスト
実装して分かったことと現在の限界
行データとインデックスを別にすると、インデックスは行ファイルから作り直せます。その設計で起動時の照合を単純にできた一方、保存済みのインデックスが正常でも、開くたびに行ファイルを全走査してツリーを組み立てるコストがかかります。書き込みでも、行は1件分の追記で済みますが、インデックスは挿入のたびに、そのテーブルに属する全ツリーを丸ごと保存します。検索で読む行を絞れる仕組みと、挿入や起動のコストを抑える仕組みは、それぞれ実装が必要だと分かりました。
メモリには定義と全インデックスを保持します。行本体はファイルから読みますが、検索結果は All がスライスにまとめるので、全件取得ではテーブルの全行が結果としてメモリに載ります。DBの操作は1プロセスでの利用を前提とし、DB単位のロックで直列化しています。更新・削除、範囲検索、JOIN、複数操作をまとめるトランザクションは未実装です。
今回の age = 20 は、追記した行の位置を控え、キーから位置を探し、必要な行を読み直すという流れだけで実現できました。保存途中で止まったときも、まず行ファイルの状態を見れば、どのキーがどの位置を指すべきかを組み直せます。ブラウザの一覧とB-treeを、同じ users.jsonl のバイト位置でつなげて見られるようになったのが、この実装で理解しやすくなった点です。
コメントを残す