「APIの応答が遅い」と分かっても、原因がそのAPIの内部にあるとは限りません。別のサービスを呼び出していて、その応答を待っている可能性もあります。
ログに処理時間を出せば個別の状況は確認できます。ただ、サービスが増えると「この呼び出しと、あちらの処理は同じリクエストなのか」を追う手間が増えてきます。
そこで、GoのAPIを2つ用意し、OpenTelemetryで処理を計測するサンプルを作りました。ブラウザから遅延やエラーを発生させ、Grafanaで「どこに原因があるか」を調べられます。
コードはotel-playgroundで公開しています。
最初に、登場するソフトを整理する
OpenTelemetryを調べると、Collector、Tempo、Prometheus、Grafanaといった名前が出てきます。それぞれの担当を整理すると、構成を理解しやすくなります。
| 名前 | 何なのか | このサンプルでの担当 |
|---|---|---|
| OpenTelemetry | 計測・送信のための共通の仕組み。Go用のライブラリもある | APIの処理時間や呼び出し回数を記録する |
| Collector | 計測データを受け取り、転送するサーバーソフト | Goから届くデータを保存先へ振り分ける |
| Tempo | トレースの保存・検索用サーバーソフト | 1回のリクエストの処理経路を保存する |
| Prometheus | 数値を時刻とともに保存する監視サーバーソフト | 呼び出し回数や処理時間の推移を保存する |
| Grafana | 保存されたデータを検索・可視化するソフト | トレースやグラフを画面に表示する |
TempoとPrometheusは、MySQLやRedisのように、それぞれ独立して起動するソフトです。Goに組み込むライブラリではありません。
また、Grafana自身がAPIの処理時間を測っているわけでもありません。この構成ではOpenTelemetryで計測し、保存された結果をGrafanaから見ています。
「トレース」と「メトリクス」の違い
システムの動作や状態を知るために出力されるデータを、テレメトリーと呼びます。代表的なものには、出来事を記録するログ、回数や時間などを数値で記録するメトリクス、処理のつながりを記録するトレースがあります。
今回のサンプルでは、このうちトレースとメトリクスを収集・可視化します。
トレースは、1回のリクエストが通った処理の道筋です。
例えば「API AがAPI Bを呼び出し、Bの内部処理で1秒待った」という関係を記録します。トレースの中にある個々の処理区間を、スパンと呼びます。
メトリクスは、呼び出し回数や処理時間などを数値として記録したものです。
「最近エラーが増えていないか」「平均応答時間が長くなっていないか」といった傾向を見るのに使います。
トレースでは個別の処理を追い、メトリクスでは全体の傾向を見る、と考えると分かりやすいと思います。
サンプルの構成
API Aは操作画面を配信し、ブラウザからのリクエストを受け付けます。API Bは、Aから呼ばれる別サービスです。
flowchart TB
    subgraph APP["アプリケーション"]
        Browser["ブラウザ<br/>学習用UI"]
        A["API A<br/>OpenTelemetry SDK"]
        B["API B<br/>OpenTelemetry SDK"]

        Browser -->|"HTTPリクエスト"| A
        A -->|"HTTPリクエスト<br/>traceparentを伝播"| B
    end

    subgraph OBS["計測データの収集・保存"]
        Collector["OpenTelemetry Collector"]
        Tempo[("Tempo<br/>トレースを保存")]
        Prometheus[("Prometheus<br/>メトリクスを保存")]

        Collector -->|"トレースを送信"| Tempo
        Prometheus -->|"メトリクスを定期取得"| Collector
    end

    A -.->|"トレース・メトリクス<br/>OTLP / HTTP"| Collector
    B -.->|"トレース・メトリクス<br/>OTLP / HTTP"| Collector

    Grafana["Grafana<br/>トレース・グラフを表示"]
    Grafana -->|"トレースを検索"| Tempo
    Grafana -->|"メトリクスを照会"| Prometheus

    classDef app fill:#e8f1ff,stroke:#4275b5,color:#172b4d
    classDef telemetry fill:#fff3df,stroke:#bb8125,color:#503611
    classDef view fill:#e5f5ed,stroke:#388460,color:#163d2b

    class Browser,A,B app
    class Collector,Tempo,Prometheus telemetry
    class Grafana view
GoからCollectorへの送信には、OpenTelemetryの通信ルールであるOTLPを使います。このサンプルではHTTPで送信します。
操作画面の「LOCAL OBSERVABILITY LAB」は、リポジトリ独自の学習用UIです。OpenTelemetryに標準で付属する画面ではありません。
起動したら、操作はブラウザから
必要なのはGo 1.27以上とDocker Composeです。リポジトリを取得し、そのルートで実行します。
git clone https://github.com/taako-502/otel-playground.git
cd otel-playground
docker compose up -d
これでCollector・Tempo・Prometheus・Grafanaが起動します。
次に、別々のターミナルでAPI BとAPI Aを起動します。
# ターミナル1
OTEL_EXPORTER_OTLP_ENDPOINT=http://127.0.0.1:4318 go run ./cmd/api-b
# ターミナル2
OTEL_EXPORTER_OTLP_ENDPOINT=http://127.0.0.1:4318 go run ./cmd/api-aOTEL_EXPORTER_OTLP_ENDPOINTは、計測データの送信先です。このサンプルでは、指定しなければターミナルへの出力だけになり、保存先には送信されません。
起動後に使う画面は次の3つです。
| 画面 | URL |
|---|---|
| 操作画面 | http://127.0.0.1:3000 |
| Grafana | http://127.0.0.1:3300/d/otel-playground |
| Prometheus | http://127.0.0.1:9090 |
まずは操作画面で「正常なAPI」「1秒待つAPI」「HTTPエラー」を押してみます。結果欄に応答とTraceIDが表示されます。
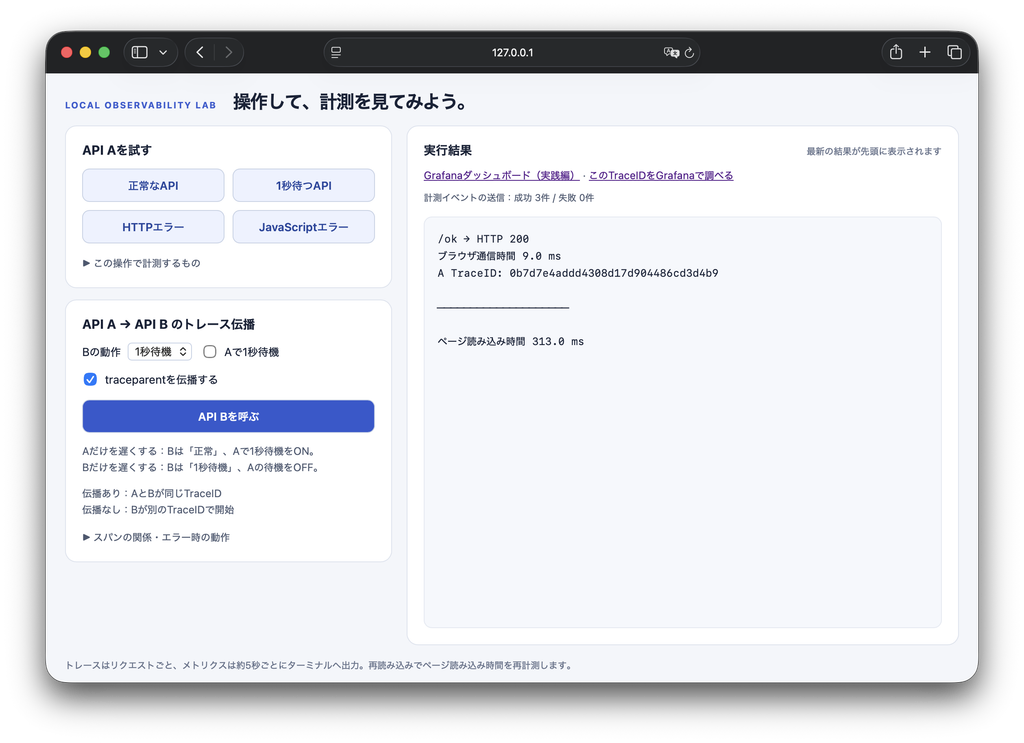
TraceIDは、ひとつのトレースを識別する番号です。後からGrafanaで処理を探すときにも使います。
API AとAPI Bの処理をつなぐ
操作画面の「API A → API B」で、「traceparentを伝播する」をONにして「API Bを呼ぶ」を押します。
伝播が有効なら、AとBのTraceIDが一致します。基本の親子関係は次のとおりです。
API A:リクエストを受信
└─ API A:BへのHTTPリクエスト
   └─ API B:リクエストを受信
      └─ API B:内部処理 simulate-work
サービスごとに別々の記録を作るだけでは、この関係は分かりません。AからBへ、現在のトレースの情報を渡す必要があります。
サンプルでは、AのHTTPクライアントをotelhttp.NewTransportで計測しています。Bを呼ぶ際には、受信したリクエストのContextを引き継ぎます。
request, err := http.NewRequestWithContext(
    r.Context(),
    http.MethodGet,
    origin+"/work?mode="+mode,
    nil,
)このContextと計測付きTransportによって、A側のHTTPクライアントのスパンが作られ、traceparentヘッダーにトレース情報が入ります。
B側ではotelhttp.NewHandlerが受信した情報を読み取り、AのHTTPクライアントのスパンにつながるスパンを作ります。
比較のため、「traceparentを伝播する」をOFFにすると、AとBは別のTraceIDになります。通信そのものは成功しても、サービスをまたいだ一本のトレースにはなりません。
この切り替えで、単に処理時間を測ることと、サービス間の関係まで記録することの違いを確認できます。
「Aが遅い」と「Bが遅い」を見分ける
このサンプルで試したいのは、どちらも応答に約1秒かかる次の2ケースです。
| ケース | 操作 |
|---|---|
| Aの内部処理が遅い | Bを「正常」にし、「Aで1秒待機」をON |
| Bの内部処理が遅い | Bを「1秒待機」にし、Aの待機をOFF |
伝播をONにして実行し、結果欄の「このTraceIDをGrafanaで調べる」を開きます。データがまだ出なければ、数秒待って再読み込みします。
Aが遅いケースでは、Aのprepare-workというスパンが約1秒になります。その後に実行されるBへの通信とBの処理は短くなります。
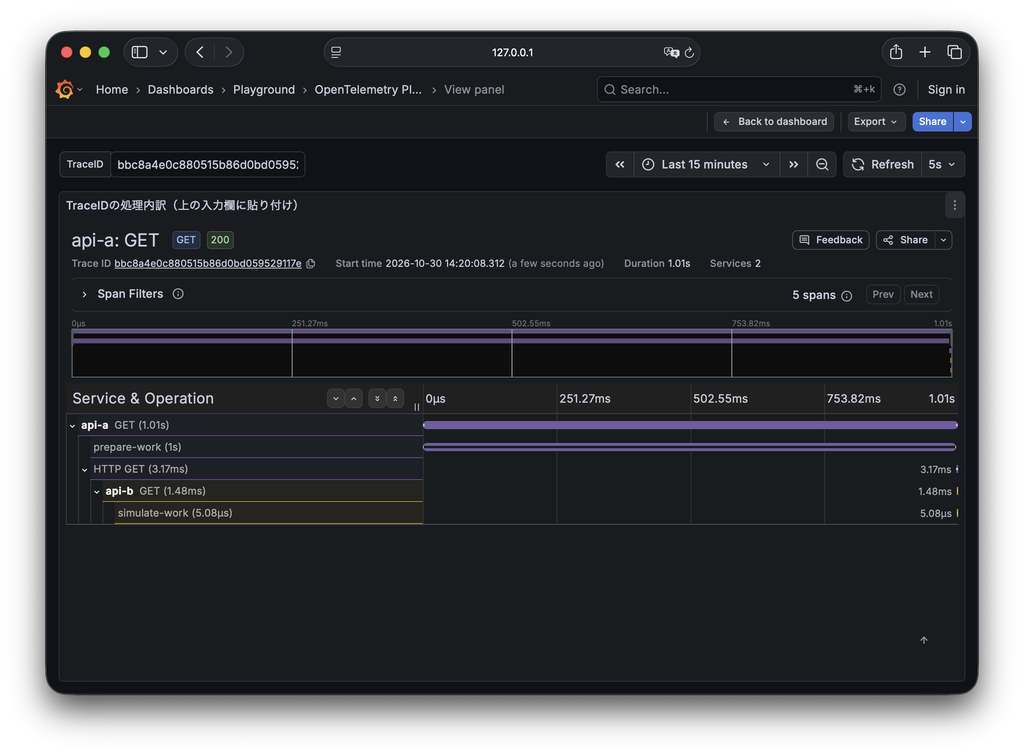
Bが遅いケースでは、Bのsimulate-workが約1秒になります。その応答を待つAのHTTPクライアントのスパンも長くなります。
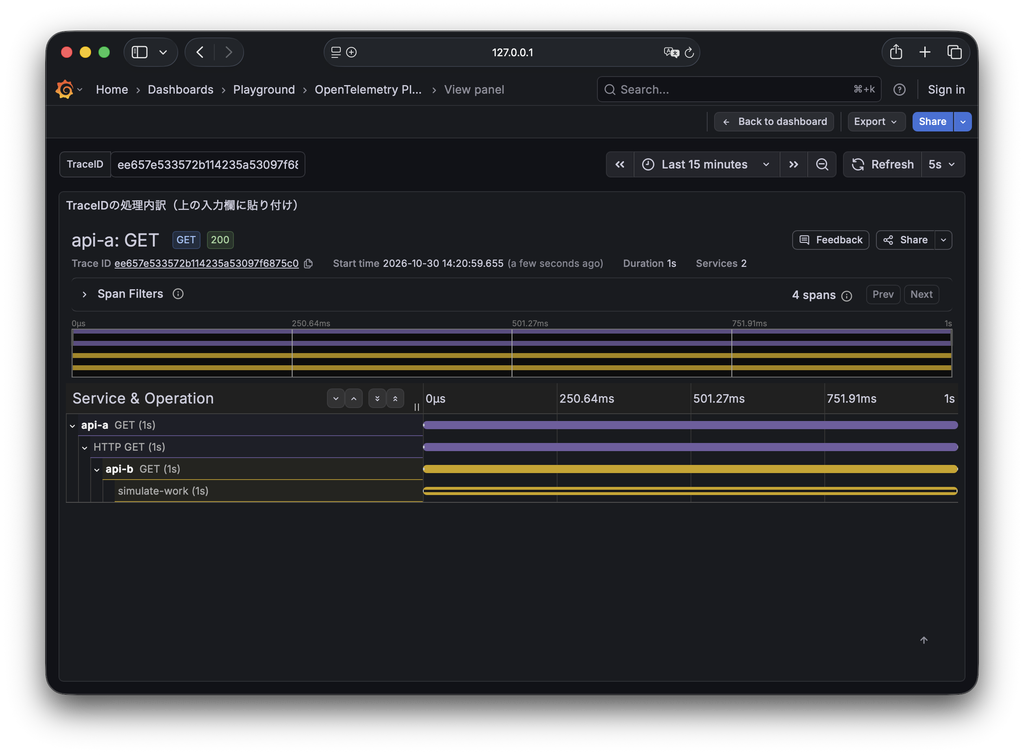
ここで注意したいのは、Aの処理時間が長いからといって、Aの内部処理が原因とは限らないことです。Bを待っている時間も、Aの処理時間に含まれます。
また、親スパンには子スパンの時間が含まれます。Aが約1秒、Bも約1秒と表示されていても、それを足して約2秒とは考えません。横棒の位置と親子関係を見ることが大切です。
エラーもサービスをまたいで確認する
Bの動作を「エラー」にすると、BはHTTP 500を返し、それを受けたAはHTTP 502を返します。
Grafanaでは、AとBのエラーになったスパンを同じトレースの中で確認できます。ブラウザから見えるのはAの応答でも、その先にあるBの処理までたどれます。
この500から502への変換は、下流サービスの失敗を区別するためのサンプルの設計です。OpenTelemetryがHTTPステータスを変換しているわけではありません。
メトリクスで全体の傾向を見る
Grafanaのダッシュボードには、次の数値も表示します。
- APIの呼び出し回数
- APIの5xxエラー率
- HTTP処理時間の平均とp95
- ボタンのクリック回数
- ブラウザから見た通信時間の平均
p95は「およそ95%の処理がこの時間以内に終わる」という目安です。このサンプルでは、処理時間の分布から近似値を求めています。
ボタンを何度か押し、10〜15秒ほど待って確認します。平均やエラー率には複数回のデータ取得が必要なので、少し時間を空けて追加で操作すると確認しやすくなります。
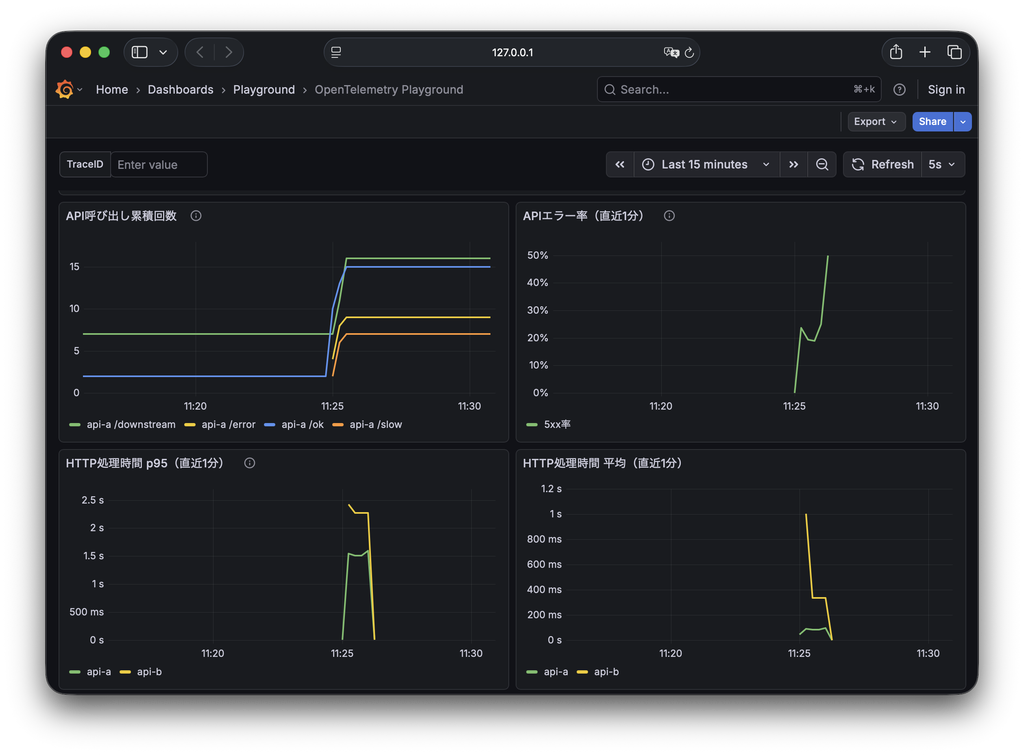
エラーを一度も発生させていない場合、エラー率がNo dataになることがあります。このサンプルでは、最初のエラーが発生するまで対応する数値の系列が作られないためです。
Prometheusの検索画面でも、保存された値を直接調べられます。例えば、API呼び出し回数は次の名前で検索します。
demo_api_requests_totalコード上の定義名はdemo.api.requestsです。CollectorがPrometheus向けに変換すると、.が_になり、累積カウンターを表す_totalが付きます。
画面で見た名前からコードを探せるよう、定義の横にはPrometheus名のコメントも付けています。
ブラウザ側で測っていること
サーバー側の処理時間と、利用者がブラウザで待つ時間は同じではありません。ブラウザ側には通信やレスポンスの読み取りなどの時間も含まれます。
このサンプルでは、ブラウザのPerformance APIなどを使い、クリック、JavaScriptエラー、ページ読み込み時間、API通信時間を記録しています。
計測値はAPI Aに送信し、GoのOpenTelemetry SDKでメトリクスに変換します。これは、実際のブラウザでの体験を測るRUMの簡易的な実装です。
ただし、ブラウザ側のスパンは作っていません。画面に出るTraceIDはAPI側のもので、今回の分散トレースの対象はAからBへの呼び出しです。
本番につながる部分と、追加で考える部分
このサンプルで学べるのは、サービス名を付けて計測すること、ContextとHTTPヘッダーでトレースをつなぐこと、保存したトレースとメトリクスから状況を調べることです。
これらは、サービスが増えた環境でも使う基本になります。
一方、ローカルで動く構成をそのまま本番に置くわけではありません。本番では認証やTLS、データの保存期間と容量、どの程度のトレースを残すか、送信先が止まった際の扱いなどを設計する必要があります。
このサンプルは全トレースを収集し、学習用に標準出力にも記録します。大量データの処理性能を検証した構成ではありません。また、DBの計測やログの集中管理も対象にしていません。
終了するときは、API A/BのターミナルでCtrl+Cを押し、次を実行します。
docker compose down保存データはボリュームに残ります。この構成での保持期間は、Tempoが24時間、Prometheusが7日間です。
まずは、同じ「約1秒の応答」でも、Aが遅い場合とBが遅い場合でトレースの形がどう変わるかを比べてみてください。数値だけでは分からなかった待ち時間の理由が、処理のつながりとして見えるようになります。
コメントを残す