前回は、Goでテーブルの行をファイルに保存し、B-treeインデックスを使って検索するRDBを作りました。今回は、あるDBへの変更を別のDBにも反映する仕組み、レプリケーション(複製)を追加しました。前回の記事
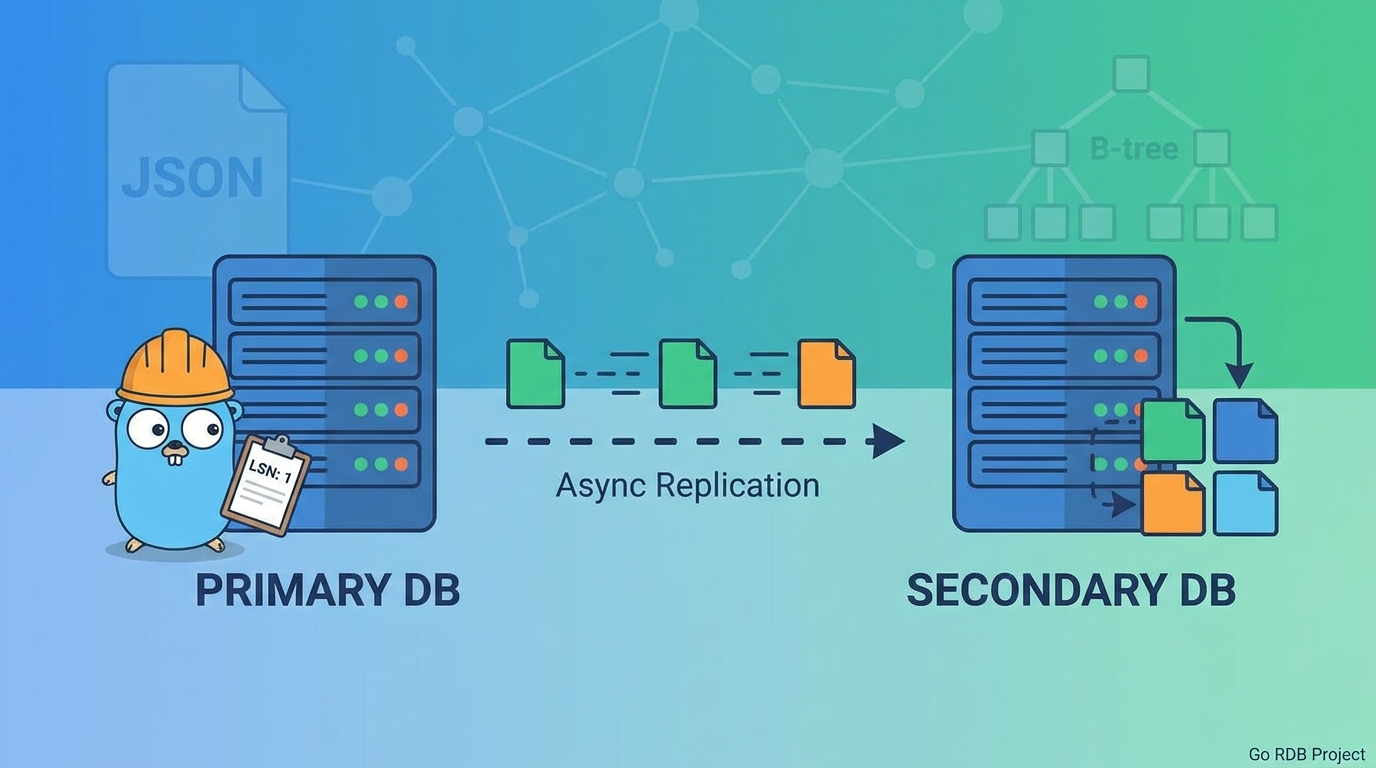
書き込みを受け付けるDBをPrimary、その変更を受け取って自分のデータを更新するDBをSecondaryと呼びます。今回の実装では、Primary 1台と、そのデータを複製するSecondaryを合わせてレプリカセットと呼んでいます。
今回のDBは非同期複製を使います。Primaryは自分のDBに変更を保存した時点で、書き込み元に成功を返します。その時点では、Secondaryにまだ変更が反映されていないことがあります。
GitHubでソースコードを見る(go-rdbms-playground)
レプリカセットを使う2つの目的
1つ目は、障害に備えることです。 たとえば別のサーバーにSecondaryを置いておけば、Primaryのサーバーが故障しても、複製済みのデータはSecondaryに残ります。そのSecondaryを新しいPrimaryに切り替えれば、書き込みを再開できます。ただし、非同期で複製する場合、故障の直前に書いたデータはまだ届いていないことがあります。
2つ目は、読み取りの負荷を分けることです。 たとえば、ユーザー登録直後の確認画面はPrimaryから読み、管理画面に表示する登録者数の集計はSecondaryに任せます。登録者数は少し前の値でもよい、という条件なら、集計のたびにPrimaryが全ユーザーを数える必要がなくなります。
今回のExplorerでは、Primaryに追加した行をSecondaryからも読める様子を観察できます。画面から追加したSecondaryはPrimaryと同じGoプロセスで動くため、プロセスを止めると両方が停止します。
usersテーブルに100行ある状態でSecondaryを追加し、その後、Primaryに101行目を書き込むとします。既存の100行はスナップショットでコピーし、追加した1行は複製ログで届けます。この流れを、実際に保存するファイルと対応づけて説明します。
既存の100行をスナップショットでコピーする
Explorerの設定でレプリカセットをONにすると、100行を持つ今のDBがPrimaryになります。続いてポートを指定してSecondaryを追加すると、Primaryはその時点の行データと複製位置をまとめてコピーします。このコピーをスナップショットと呼びます。
たとえば、Primaryの users.jsonl にある100行はそのままSecondaryに渡します。検索用のB-treeは、受け取った行データとテーブル定義からSecondaryが組み立てます。
| ファイル | 役割 | Secondary追加時 |
|---|---|---|
| users.jsonl | usersの行データ本体 | コピー |
| catalog.json | テーブル名、カラムの型、主キー、インデックスの定義 | コピー |
| migrations.json | 適用済みのスキーマ変更のバージョンとチェックサム | 履歴があればコピー |
| replica.json | 複製元のIDと、コピーに含まれる最後の変更の位置 | コピー |
| users.id.index.json | 主キーidから行の保存位置を引くB-tree | Secondaryで再構築 |
| users.age.index.json | ageから行の保存位置を引くB-tree | Secondaryで再構築 |
コピー中はPrimaryへの書き込みを一時停止します。100行をコピーした直後に101行目が追加され、複製位置だけが先に進むと、Secondaryは101行目を持っていないのに適用済みと判断してしまいます。行データと複製位置を同じ時点にそろえることで、この取りこぼしを防ぎます。
101行目は複製ログで届ける
複製ログは、Secondaryが後から同じ変更を適用するための記録です。LSN(Log Sequence Number)はログ内の位置を表します。このDBでは、変更を記録するたびに1ずつ増える通し番号を使います。既存の100行を持ったまま複製を始めた場合、101行目の追加が最初の変更なので、ユーザーのIDは101、LSNは1です。
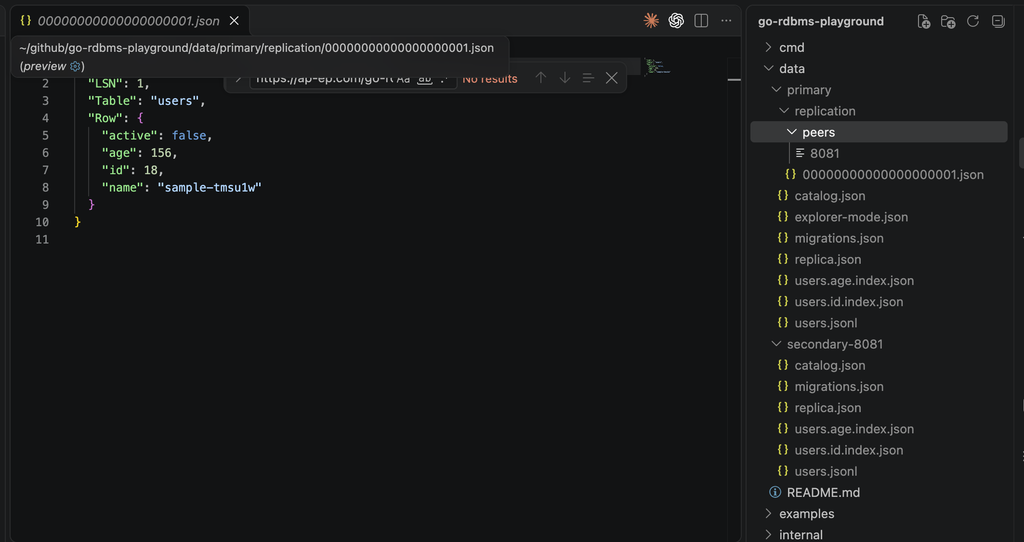
Primaryはまず replication/00000000000000000001.json に変更を保存します。ファイル名はLSNを20桁にゼロ埋めしたもので、1変更につき1ファイルです。行を追加した場合、ログには次の内容が入ります。
{
  "LSN": 1,
  "Table": "users",
  "Row": {"active": true, "age": 28, "id": 101, "name": "Sato"}
}
Primaryは自分のusers.jsonlに行を追加し、インデックスを更新して、replica.jsonに適用済みの位置を保存します。replica.jsonのSourceは複製元を識別するID、LSNはそのノードが最後に適用した変更番号です。
Secondaryは起動時に指定されたPrimaryのURLへ、自分のSourceと適用済みLSNを送ります。この例ではLSN 0を送るので、Primaryはその続きであるLSN 1の変更を返します。Secondaryがその変更を自分のテーブルに適用すると、Secondaryのreplica.jsonもLSN 1に進みます。
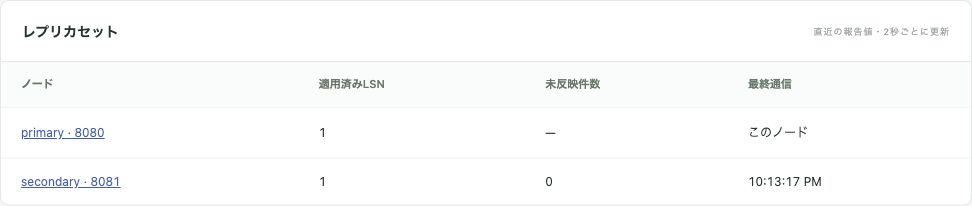
Explorerの管理用ファイルもあります。explorer-mode.jsonは画面で選んだ複製モードを再起動後に復元するために使います。Primary側のreplication/peers/8081は、ポート8081のSecondaryの登録を表します。Primaryは再起動時にこの登録を読み込み、複製先一覧を復元します。
書き込み直後にSecondaryを検索するとどうなるか
101行目を追加するときの状態を順に並べます。
| タイミング | Primary | Secondary |
|---|---|---|
| スナップショット取得直後 | 100行・LSN 0 | 100行・LSN 0 |
| Primaryに追加済み、Secondaryは未取得 | 101行・LSN 1 | 100行・LSN 0 |
| Secondaryにも適用済み | 101行・LSN 1 | 101行・LSN 1 |
Primaryを8080、Secondaryを8081で起動し、表の2行目の時点でid = 101を検索すると、8080では見つかり、8081ではまだ見つかりません。Secondaryは自分の行データとインデックスを使って読み取りに答えます。書き込みからSecondaryへの反映までの遅れを複製遅延(レプリケーションラグ)と呼びます。
たとえばGoアプリケーションでは、登録直後のユーザー情報を表示する処理にはPrimaryへの接続を渡し、多少の遅延を許容できる集計にはSecondaryへの接続を渡せます。
ノードが停止した場合
Secondaryだけが停止した場合、再起動後に自分のreplica.jsonを読み、最後に適用したLSNの続きをPrimaryから取得します。必要なログがPrimaryに残っていれば、既存の100行をコピーし直さずに追いつけます。
Primaryだけが停止しても、別プロセスで動くSecondaryは適用済みの行を返せます。ただし、どのSecondaryにも届いていない状態でPrimaryのディスクを失うと、成功を返した書き込みでも失われる可能性があります。今回の実装では、Primary停止時にSecondaryを新しいPrimaryに切り替える自動フェイルオーバーは行いません。
画面から追加したSecondaryは、Primaryとポート・保存先を分けて同じGoプロセスで動きます。片方だけを停止する実験には、CLIから別々のプロセスで起動します。Secondaryを止めた間にPrimaryへ行を追加し、Secondaryを再起動すると、users.jsonlに追加した行が現れ、replica.jsonのLSNがPrimaryに追いつく過程を確認できます。
例:ATMで出金した直後にPrimaryが停止したら
複製が追いつく前にPrimaryが停止すると、成功を返した書き込みはどうなるでしょうか。ここでは、ATMで残高1万円の口座から8,000円を引き出す場面を例に考えます。
Primaryが残高を2,000円に更新して成功を返し、ATMが現金を払い出しました。その直後、出金記録がSecondaryに届く前にPrimaryが停止します。このSecondaryを新しいPrimaryにすると、口座の残高はまだ1万円です。ここでもう一度8,000円の出金を受け付けると、最初に1万円しかなかった口座から合計1万6,000円を引き出せてしまいます。
PostgreSQLでは、あらかじめ同期先のスタンバイを構成しておくと、複製先への保存を待つかどうかをトランザクションごとに選べます。たとえばアクセスログの追加には synchronous_commit = local を使い、Primaryでの永続化が済んだ時点で成功を返します。一方、出金では残高の更新と出金履歴の追加を1つのトランザクションにまとめ、その中で SET LOCAL synchronous_commit = on を指定します。これで、同期先がその取引のログをディスクに保存するまでコミットの成功応答を待ちます。
この設計では、ATMはコミット成功を受け取ってから現金を払い出し、障害時にはその出金記録を保持するノードを新しいPrimaryにします。その分、同期先から確認が返らない間は出金も待たされます。今回の自作RDBは全テーブル一律の非同期複製です。PostgreSQL公式ドキュメントの同期レプリケーション設定
おすすめ
GitHubからチェックアウトして操作したりコードを読んでみることをおすすめします。
以下のスクリーンショットを見るとわかるように、レプリカセットのON/OFFを切り替えたり、セカンダリーサーバーの追加・削除をする操作をUIからできるようにしています。
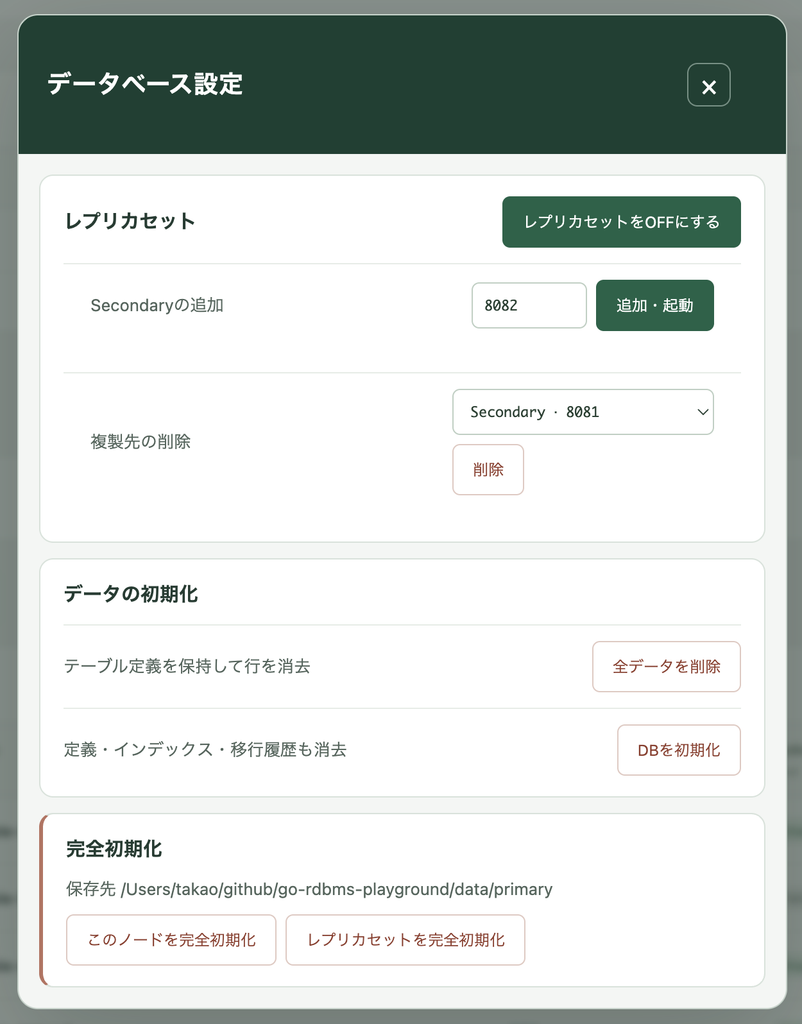
データベースに保存されているデータやデータベースの定義、レプリカセットの内容は全て/dataディレクトリに保存されています。あえてバイナリ化しないで保存しているため、中身を簡単に解析することができます。
UIからデータを追加・削除などの操作をして、/dataディレクトリの中を読むことでより理解が深まると思います。
連載
本記事は連載です。興味があれば以下のリンクから閲覧してください。
- Vol. 1 Goでリレーショナルデータベース自作してみた
- Vol. 2 Goで自作したRDBに非同期レプリケーションを追加した
- Vol. 3 Goで自作したRDBにシャーディングを追加した(執筆中)
コメントを残す