機械学習では、データを使ってモデルを学習させます。
言葉としては分かりますが、「何を学習しているのか」「学習すると何が変わるのか」は、説明を読むだけだと少しつかみにくいところがあります。
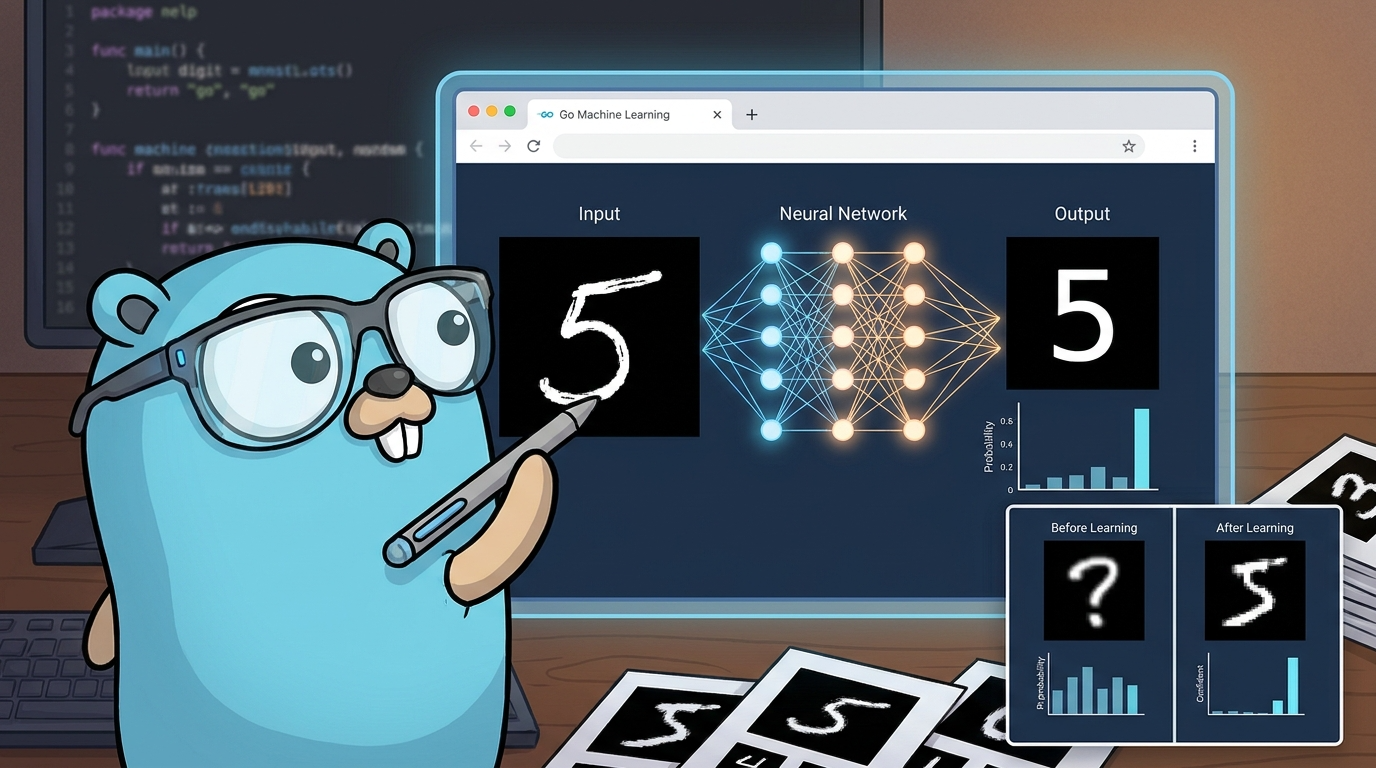
そこで、Goで学習処理を実装し、ブラウザに描いた数字を認識するサンプルを作りました。学習前と学習後のモデルを切り替えて、同じ画像に対する答えの違いを確認できます。
機械学習ライブラリは使わず、Goの標準ライブラリだけで実装しています。学習の流れを理解するために、アイスクリームの販売数を予測する線形回帰のサンプルも用意しました。
コードは go-ml-playground で公開しています。
まずは数字を描いて試す
必要なのはGo 1.27以降です。リポジトリを取得し、次のコマンドを実行します。
git clone https://github.com/taako-502/go-ml-playground.git
cd go-ml-playground

go run ./cmd/digit-recognition初回は学習に使う画像データを約11MBダウンロードし、data/mnist/に保存します。2回目以降は保存したデータを使います。
学習が終わると、report-digits.htmlが生成されます。ブラウザで開いてください。
# macOSの場合
open report-digits.html
WindowsやLinuxでも、生成されたファイルをブラウザで開けば利用できます。
黒いキャンバスに0〜9の数字を1文字描くと、右側に判定結果が表示されます。「使うモデル」を切り替えると、同じ入力を学習前と学習後で比較できます。
下にはテスト用の画像も並べているので、クリックして試すこともできます。
学習するのはGo側です。ブラウザでは、HTMLに保存された学習済みの値を使って答えを計算します。この、学習したモデルで答えを求める処理を「推論」と呼びます。
生成後のHTMLはオフラインでも動きます。PythonやGPU、APIキーは不要です。
数字を教えるためのMNIST
学習には、MNIST(エムニスト)というデータセットを使っています。
手書きの数字0〜9の画像と、「この画像の正解は3」といった正解ラベルを集めたものです。画像は28×28ピクセルのグレースケールで、学習用60,000枚とテスト用10,000枚が用意されています。今回はCVDFの公開ミラーから取得しています。
このサンプルでは、デフォルトで次のように分けて使います。
| 用途 | 枚数 | 役割 |
|---|---|---|
| 学習用 | 20,000枚 | 予想と正解のズレからモデルを調整する |
| 検証用 | 5,000枚 | 学習途中の出来を確認する |
| 最終テスト用 | 10,000枚 | 学習を終えてから正解率を測る |
学習用と検証用は、MNISTの学習用60,000枚から重ならないように取り出しています。残りの35,000枚は、デフォルト設定では使いません。
検証用やテスト用の画像で間違えても、その画像を使ってモデルの値を更新することはありません。練習した画像だけでなく、練習に使っていない画像でも数字を見分けられるか確かめるためです。
学習前は、答えが出ても当てずっぽうに近い
学習前のモデルも、画像を入力すると0〜9のどれかを答えます。
ただし、内部の「重み」と呼ばれる値はランダムな状態です。画像を計算する仕組みはあっても、数字の見分け方はまだ学んでいません。
そこに画像と正解を与えて、次の処理を繰り返します。
- 画像から、どの数字かを予想する
- 正解ラベルと比べて、予想のズレを計算する
- ズレが小さくなる方向へ、内部の値を少し調整する
「輪があるから0」「縦棒だから1」といったルールを、人が書いているわけではありません。画像と正解の組を使って、判定に使う値を調整しています。
今回、デフォルト設定で実行した結果は次のようになりました。
| タイミング | 検証用5,000枚の正解率 |
|---|---|
| 学習前 | 11.02% |
| 1周学習した後 | 93.24% |
| 5周学習した後 | 96.48% |
学習終了後に、別のテスト用10,000枚で測った正解率は 95.31%(9,531枚正解) でした。
学習前後を画面で切り替えると、内部の値を調整したことが、答えの違いとして見えてきます。
ニューラルネットワークの中では何をしているのか
今回のモデルは、全結合ニューラルネットワークという比較的単純な構成です。
28×28ピクセルの画像
        ↓
784個の画素の値
        ↓
64個の中間の計算
        ↓
0〜9の10個のスコア
        ↓
最もスコアが高い数字を答える
画像の各画素を0〜1の数値にして入力し、重みを掛けて足し合わせる計算などを通して、10個のスコアを求めます。
調整する重みとバイアスは、合計50,890個あります。学習では、この値を少しずつ変えます。
デフォルトでは32枚ずつ画像をまとめてズレを計算し、値を更新します。20,000枚を一通り使うと1周、つまり1 epochです。今回はそれを5周繰り返します。
5 epochだから値を5回だけ更新する、という意味ではありません。1周の中で何度も更新しています。
処理をコードで追う場合は、network.goのforward、gradients、trainEpochの順に読むと、予想・ズレからの計算・学習の繰り返しを確認できます。
「予想して、直す」を直線で見る
数字認識では調整する値が多いので、何が動いたのかを直接見るのは難しいです。
そこで、もう一つのサンプルでは、気温からアイスクリームの販売数を予測します。
go run ./cmd/linear-regression -html report-linear-regression.html

# macOSの場合
open report-linear-regression.html
こちらは架空の100日分の記録を作り、80件を学習用、20件を評価用に分けています。
学ぶのは、次の式の「傾き」と「上下の位置」です。
予測販売数 = 傾き × 気温 + 上下の位置最初は、どんな気温でも販売数を0個と予想します。そこから次の処理を繰り返します。
今の直線で80件を予想する
        ↓
同じ80件の正解と比べる
        ↓
ズレが小さくなるように直線を少し直す
        ↓
直した直線で、もう一度80件を予想する
このサンプルでは、80件すべてのズレをまとめてから、直線を1回調整します。これを2,000回繰り返します。
別に分けた20件は、出来を確かめるためのものです。画面に表示するために学習途中でも評価しますが、その結果を使って直線を直すことはありません。
スライダーを動かすと、予測直線と誤差のグラフが連動します。直線の傾きだけでなく、上下の位置も変わることを確認できます。
2,000回も繰り返す必要はあるのか
動かしてみると、最初の1回で直線がかなりデータに近づきます。
実際に、評価用20件の誤差を確認すると次のようになりました。RMSEは、販売数と同じ「個」の単位で表せる誤差の指標で、小さいほど予測が正解に近いことを示します。
| 学習回数 | 評価RMSE |
|---|---|
| 0回 | 200.45個 |
| 1回 | 14.45個 |
| 100回 | 14.32個 |
| 2,000回 | 14.32個 |
この条件では、後半の改善は小さくなっています。2,000回という設定は、必ずそれだけの回数が必要という意味ではありません。
さらに、このような単純な線形回帰は、公式を使って最適な直線を直接求めることもできます。
今回は「予想する、ズレを調べる、少し直す」という学習方法を見える形にするため、繰り返して調整する勾配降下法を使っています。
数字認識のニューラルネットワークでも、扱う計算は複雑になりますが、予想と正解のズレから値を調整する流れは共通しています。
正解率95%でも、自分の字を必ず読めるわけではない
数字認識に戻ると、テスト正解率が95.31%だからといって、自分が描いた数字も同じ割合で当たるとは限りません。
マウスで描く文字とMNISTの画像では、線の太さや傾き、形が違います。
このサンプルでは、描いた部分を切り出し、縮小して中心を合わせてから入力しています。それでも、書き方によっては間違えます。
また、画面のバーはモデルが出したスコアです。スコアが高くても、答えが正しい保証にはなりません。数字以外の絵を描いた場合も、0〜9のどれかに分類します。
画面下部には、テスト画像のうち間違えた例も並べています。正解した数字だけでなく、どの形を取り違えるのかを見ると、モデルの苦手なところも分かります。
条件を変えて試す
動きを確認できたら、学習に使う画像の枚数を減らしてみます。
go run ./cmd/digit-recognition \
  -train 1000 \
  -html report-digits-small.html
次は、途中の計算に使う隠れ層の数を64から8に減らしてみます。
go run ./cmd/digit-recognition \
  -hidden 8 \
  -html report-digits-narrow.html
元のHTMLと見比べると、条件によって検証正解率や判定結果がどう変わるか確認できます。一度にいくつも変更するより、まずは一つずつ変える方が違いを追いやすいです。
なお、最終テストの点数を見ながら何度も設定を選ぶと、そのテストに都合のよい設定を探すことになります。設定の比較には検証結果を使い、最終テストは最後の確認として扱います。
今回作ってみて、学習とは「データを入れたら知識が増える」という曖昧なものではなく、予想のズレをもとに数値を調整する処理なのだと捉えやすくなりました。
まずは同じ数字を入力したまま、学習前と学習後を切り替えてみてください。直線のサンプルと合わせて見ると、画面の裏で何を調整しているのかもイメージしやすいと思います。
ソースコードと詳しい実行方法は、go-ml-playgroundにまとめています。
コメントを残す